Jahr: 2012

  • OAuth 2 Logo

    So, jetzt muss ich mich auch mal zu der OAuth Geschichte äußern! Wer nicht weiß warauf ich anspiele, der sollte sich zuerst mal Eran Hammers Blogpost durchlesen: OAuth 2.0 and the Road to Hell.

    Auf alle Kritikpunkte von Eran Hammer möchte ich gar nicht eingehen… Ich kann seine Kritik durchaus verstehen und teile sie auch weitestgehend. Auch ich bin generell der Freund von schlanken Spezifikationen und hasse Standards die versuchen alles abzudecken und jedes Format zu unterstützen.

    Abgesehen von den ganzen Sicherheitsaspekten und dem Fokus auf „Enterprise“-Anwendungen welche Eran Hammer in seinem Artikel erwähnt, hat mich die Fehlende Interoperability von OAuth 2 zuerst am Meisten genervt:

    OAuth 2.0 provides a rich authorization framework with well-defined security properties. However, as a rich and highly extensible framework with many optional components, on its own, this specification is likely to produce a wide range of non-interoperable implementations.

    Mein erster Gedanke: Na toll! Man macht sich hier Gedanken über dezentrale Netzwerke, für die man einfache und simple Spezifikationen braucht und Familie OAuth released ein „Framework“…

    Aber eigentlich ist ja gerade das auch eine riesen Chance für das Web! Während OpenID Connect bestimmt, dass jeder Provider die komplette Spezifikation implementieren muss:

    The OpenID Connect Basic Client profile only documents Clients using the Code Flow. OpenID Providers MUST support both flows. OpenID Providers should consult the OpenID Connect Standard 1.0 Specification.

    bleibt es jedem frei gestellt welchen Teil von OAuth 2 er umsetzt… Also warten wir doch einfach ab, bis das „Framework“ fertig ist, suchen uns die für das Web eleganteste Variante raus, dokumentieren sie schön und fertig ist „OAuth 2 – The Web Edition„.

    …nicht perfekt, aber es könnte auch schlimmer sein!

    3 Kommentare zu OAut(sc)h
  • mf-white

    microformats.org wird 7… Alles Gute!

    Zur Feier des Tages hat sich Frances Berriman die Mühe gemacht, die letzten 7 Jahre zusammen zu fassen und einen Ausblick auf die kommenden Änderungen zu geben.

    Da ich, seit ich bloggen kann, schon über Microformats berichte, will ich den Rückblick nicht weiter kommentieren und nur auf die kommende Weiterentwicklung ein wenig eingehen.

    Microformats und HTML5

    Seit dem ich das letzte mal über diese Kombination geschrieben habe, hat sich leider nicht viel geändert… Die Microformats Community weigert sich weiterhin auf Microdata oder RDFa „upzugraden“ und hält krampfhaft an den semantischen classes fest. Nichtsdestotrotz macht HTML5 mit <time /> und <data /> dem leidigen Thema abbr-design-pattern bzw. value-class-pattern ein Ende. Statt Meta-Informationen umständlich in HTML-Attributen zu verwurschteln, können Termine und GEO Daten bald sauber dargestellt werden:

    <time class="dtstart" datetime="2006-09-23">a Saturday</time>
    ...
    <data class="geo" value="37.386013;-122.082932" >Mountain View</data>Code-Sprache: HTML, XML (xml)

    Immerhin! Mehr dazu im microformats-wiki.

    Namespaces

    Die wohl größten Veränderungen sind aber die geplanten Pseudo-Namespaces welche hauptsächlich das Parsen von Microformats vereinfachen sollen. Microformats waren bisher sehr fehleranfällig, da sie sich die class-Attribute mit CSS und JavaScript zu teilen hatten. Es besteht immer die Gefahr dass rein für CSS genutzte Attribute fälschlicherweise für Microformats genutzt wurden oder dass die semantischen Class-Names einem Re-Design zum Opfer fielen. Die Prefixes ‚h-‚, ‚p-‚, ‚u-‚, ‚dt-‚ und ‚e-‚ sollen das Zukünftig verhindern und ein generisches parsen ermöglichen.

    'h-' kennzeichnet einen Microformats-Container

    Bisher ist die Microformats Community etwas inkonsequent mit der Benennung ihrer Formate… Mal mit beginnendem „v“, mal mit „h“ und in seltenen Fällen auch ohne oder mit anderem Buchstaben:

    • hCard: class="vcard"
    • hAtom: class="hfeed"
    • adr: class="adr"
    • xFolk: class="xfolkentry"
    • XOXO: class="xoxo"

    Mit den Prefixes soll das jetzt alles vereinheitlicht werden:

    • hCard: class="h-card"
    • hAtom: class="h-feed"
    • adr: class="h-adr"

    'p-' zeichnet Properties aus

    Die mit ‚p-‚ gekennzeichnet Properties sollten, wenn nicht expliziert definiert, als Plain-Text interpretiert werden (kein HTML). Ein klassisches Property ist beispielsweise der Name einer Person:

    <div class="h-card">
     <span class="p-fn">Tantek Çelik</span>
    </div>Code-Sprache: HTML, XML (xml)

    'e-' zeichnet Rich Text aus

    Das ‚e-‚ Prefix könnte als Abkürzung für „element tree“, „embedded markup“, oder „encapsulated markup“ stehen und kann im Gegansatz zu den Properties auch HTML-Code beinhalten. In hAtom könnte der entry-content zu e-entry-content und bei der hReview die description zur e-description werden.

    'dt-' für DateTime und 'u-' für URL

    Aus dtstart wird dt-start und alle URL-Felder bekommen ein vorgestelltes ‚u-‚:

    <a class="u-url" href="...">...</a>
    
    <img class="u-photo" src="..." />Code-Sprache: HTML, XML (xml)

    Die URL kann in bestimmten Situtionen auch weg fallen, dazu aber im nächsten Beispiel mehr…

    Simpel und unabhängig vom Format

    Zukünftig soll es auch nicht mehr so umständlich sein Informationen semantisch auszuzeichnen. Will man derzeit einen simplen Link mit einer hCard versehen, muss man ihn wie folgt aufblähen:

    <div class="vcard">
     <a class="url fn" href="http://tantek.com/">Tantek Çelik</a>
    </div>Code-Sprache: HTML, XML (xml)

    Nach der Überarbeitung soll folgendes reichen:

    <a class="h-card" href="http://tantek.com/">Tantek Çelik</a>Code-Sprache: HTML, XML (xml)

    Dabei gilt die Regel: Wenn es sich bei (z.B.) einer vCard um einen Link oder ein Bild handelt, kann man auf ‚u-*‚ und ‚p-name‚ verzichten… so ungefär zumindest 😉

    Mehr dazu im Microformats-Wiki: implied properties

    Außerdem kommt mit v2 eine Anleitung wie Microformats auf andere Formate wie JSON gemappt werden sollen. Aus…

    <a class="h-card" href="http://benward.me">Ben Ward</a>Code-Sprache: HTML, XML (xml)

    wird…

    [{
      "type": ["h-card"],
      "properties": {
        "name": ["Frances Berriman"] 
      }
    }]Code-Sprache: JSON / JSON mit Kommentaren (json)

    Fazit

    Ich bin mir noch nicht ganz sicher was ich von den geplanten Änderungen halten soll… die Nutzung der neuen HTML5 Tags und die Vereinfachung und Vereinheitlichung der Formate finde ich gut und notwendig… Auch eine einheitliche Regel, wie Microformats in anderen Formaten abgebildet werden sollen (z.B. JSON) macht durchaus Sinn (warum das Sinn macht, hier)… aber den Pseudo-Namespaces kann ich bisher nichts abgewinnen! Der „Namespace“ sorgt zwar für mehr Qualität beim Parsen der Microformats, aber auf Kosten des semantischen HTMLs.

    Microformats sollten weiterhin für schönes, semantisches HTML sorgen und mehr nicht. Geht es um maschinenlesbaren Code, sollte man mit der Zeit gehen und auf Microdata oder RDFa setzen. Ob man seinen Quelltext an Microformats v2 anpasst oder mit Schema.org auszeichnet sollte kaum mehr Aufwand sein.

    …Übrigens: Wer noch mehr über die Vorteile von Microdata gegenüber Microformats lesen will, sollte sich die Ausgabe 10 des Webstandards-Magazin durchlesen oder die Reihe „Microdata – wie Microformats bloß besser…“ hier im Blog!

    10 Kommentare zu Microformats: The next generation
  • Anfang der Woche hat Martin Weigert schon über Twitters Pläne, die eigenen Tweets mit noch mehr Medieninhalten zu erweitern, geschrieben:

    Immer mehr Partnerseiten können zusätzliche multimediale Inhalte im Kontext von Tweets darstellen. Ganz eindeutig ist bisher nicht, wohin diese Reise für Twitter geht.

    Aber ich habe mir nichts weiter dabei gedacht… Immerhin macht das Twitter ja schon seit einer ganzen Weile und ich meine mich zu erinnern, irgendwo gelesen zu haben, dass sie dazu oEmbed einsetzen… Also alles in bester „OpenWeb“-Ordnung 🙂

    Aber, Geek der ich bin, hab ich mir gestern zufällig einen Quelltext angeschaut in dem ich auf folgendes entdeckt habe:

    <meta name="twitter:card" content="summary">
    <meta name="twitter:url" content="...">
    <meta name="twitter:title" content="...">Code-Sprache: HTML, XML (xml)

    …und nach kurzem googlen bin ich auf die Twitter Cards gestoßen, Twitters eigenes, kleines Open Graph Protocol. Mit den Twitter Cards bekommen Seitenbetreiber ein Set an Meta-Tags an die Hand, und Twitter kann diese Informationen nutzen um die tweets mit den oben erwähnten Mediendaten anzureichern.

    Example Twitter Card

    …und ich wollte mich gerade darüber aufregen, warum Twitter dazu eine eigene Meta-Sprache erfindet, da bin ich in der Doku ironischerweise auf folgendes gestoßen:

    You’ll notice that Twitter card tags look similar to OpenGraph tags, and that’s because they are based on the same conventions as the Open Graph protocol. If you’re already using OpenGraph to describe data on your page, it’s easy to generate a Twitter card without duplicating your tags and data. When the Twitter card processor looks for tags on your page, it first checks for the Twitter property, and if not present, falls back to the supported Open Graph property. This allows for both to be defined on the page independently, and minimizes the amount of duplicate markup required to describe your content and experience.

    „Ok“, dachte ich… vielleicht reichen die Open Graph Properties ja nicht aus um alle Informationen, die Twitter braucht, abzubilden. Also hab ich mir mal die Mühe gemacht sie zu vergleichen:

    Twitter CardsOpen Graph Protocol
    twitter:cardog:type
    twitter:siteog:site_name
    twitter:urlog:url
    twitter:descriptionog:description
    twitter:titleog:title
    twitter:imageog:image
    twitter:image:widthog:image:width
    twitter:image:heightog:image:height
    twitter:player oder twitter:player:streamog:video oder og:audio
    twitter:player:widthog:video:width
    twitter:player:heightog:video:height

    Es lässt sich also prinzipiell alles mit dem Open Graph Protocol abbilden, es fehlen lediglich die Felder twitter:site:id und twitter:creator:id. Aber wegen diesen zwei Feldern muss man doch nicht das ganze Format „kopieren“. Es reicht doch ein kleiner Absatz, wie man den Open Graph mit den proprietären Werten erweitert… So wie das auch Facebook praktiziert:

    <html xmlns="http://www.w3.org/1999/xhtml"
          xmlns:og="http://ogp.me/ns#"
          xmlns:fb="https://www.facebook.com/2008/fbml">
          xmlns:twitter="https://dev.twitter.com/docs/cards">
      <head>
        <title>The Rock (1996)</title>
        <meta property="og:title" content="The Rock"/>
        <meta property="fb:admins" content="USER_ID"/>
        <meta property="twitter:site:id" content="@USER_ID"/>
        ...
      </head>
      ...
    </html>
    Code-Sprache: HTML, XML (xml)

    Hoffentlich überlegt sich das Twitter noch einmal… Wenn nicht, wird dank dieser (und folgender) Redundanzen der <head /> einer Webseite in ein paar Jahren mehr Informationen beinhalten wie der <body />.

    …welch ein Over-<head> 🙂

    1 Kommentar zu Twitter Cards
  • Pfefferles OpenWeb: Web Intents

    Seit Freitag ist die zweite Ausgabe des SCREENGUI-Magazins (mit dem Fokus auf E-Payment, CSS4 und Boilerplates) in allen Bahnhofs- oder Flughafen-Buchhandlungen erhältlich.

    In „Pfefferles OpenWeb“ geht es diesmal um Web Intents:

    Seit Webseitenbetreiber das Potenzial von sozialen Netzwerken erkannt haben, nimmt die Anzahl der share, like, bookmark und +1 Buttons stetig zu und entwickelt sich zu einer regelrechten Plage. Jeder Besucher soll die Möglichkeit bekommen, seine Entdeckung schnellstmöglich mit seinen Freunden zu teilen – egal auf welcher Plattform. Um diesem Problem Herr zu werden, arbeitet Google seit ein paar Wochen an einem Framework namens Web Intents.

    Viel Spaß beim lesen!

    3 Kommentare zu Pfefferles OpenWeb: Web Intents
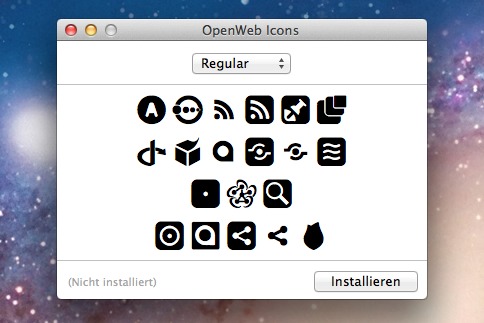
  • Wie kommt jemand mit relativ beschränktem Talent in gestalterischen Dingen dazu, einen Font zu basteln? Naja… "Font" wäre etwas übertrieben… Eigentlich hat mich ja nur genervt, dass Font Awesome kein RSS-Icon hat… und nach einer kleinen Internet Recherche hat sich herausgestellt, dass das Icon-Font erstellen gar nicht so schwer ist:

    Also hab ich noch weitere Icons gesammelt (nur das RSS-Icon wäre etwas langweilig gewesen ;)), sie mit Inkscape entsprechend bearbeitet und irgendwie ist daraus überaschenderweise wirklich so ne Art Font entstanden 🙂

    Ich präsentiere die OpenWeb Icons:

    OpenWeb Icons (a font)

    (weil ich nur OpenWeb kann ;))

    Eine Liste mit allen Icons, wie man sie benutzt und was sie bedeuten, findet man bei Github: http://pfefferle.github.com/openwebicons/

    Falls ihr Kritik oder Anregungen habt, dann immer raus damit! …vielleicht fällt dem Ein oder Anderen ja auch noch ein Icon ein, welches ich bisher vergessen habe.

    7 Kommentare zu I’ve made a font… kind of…
  • SCREENGUIDE Logo

    Neuer Name, neues Layout, den Fokus nicht mehr so streng auf Webstandards aber immer noch mit „Pfefferles OpenWeb“ 🙂

    Seit dem 16.03. heißt das Webstandards-Magazin offiziell SCREENGUIDE und ist in allen Bahnhofs- oder Flughafen-Buchhandlung erhältlich.

    In meiner Kolumne geht es diesmal um den Wandel im OpenWeb:

    Das OpenWeb hat keine Zukunft! Die proprietären Systeme von Twitter und Facebook haben sich durchgesetzt und die goldenen Zeiten von RSS sind vorbei. So sieht es zumindest Robert Scoble. Der kampf für ein OpenWeb und DataPortability von 2008 scheint verloren und viele der Revoltierenden arbeiten heute sogar für das damalige Feindbild Facebook.

    Kaufen! Danke!

    Keine Kommentare zu SCREENGUIDE
  • openid-complex

    Hat der erste Entwurf von OpenID Connect noch auf eine (übersichtliche) Seite gepasst, braucht der Draft der OpenID Foundation schon 7 unterschiedliche Spezifikationen.

    Wieso müssen „Standard“-Organisationen wie das W3C (z.B. RDFa) oder der OpenID Foundation denn alles so unnötig kompliziert machen? Immerhin schafft es ja sogar Facebook seinen Authentifizierungsprozess auf einer Seite zu erklären. …und noch besser! Er lässt in drei Sätzen zusammenfassen:

    1. Hol dir über folgende URL einen Access-Token:
      https://www.facebook.com/dialog/oauth?
      client_id=YOUR_APP_ID&redirect_uri=YOUR_URL
    2. Häng ihn an folgende URL, auf den du den User weiterleitest:
      https://www.facebook.com/dialog/oauth?
      client_id=YOUR_APP_ID&redirect_uri=YOUR_URL&
      scope=email,read_stream
    3. Fertsch!

    …dazu kommen eine weitere Discovery-Variante die Webfinger, host-meta, XRD, XRDS oder YADIS komplett ignoriert und eine Identity-API die SREG oder AX noch nicht einmal ähnelt!

    Mike Jones, einer der Hauptentwickler der Spezifikation, schreibt zwar:

    The design philosophy behind OpenID Connect is “make simple things simple and make complex things possible”.

    Das ist aber nur die halbe Wahrheit. Webseitenbetreiber, die zukünftig einen OpenID Connect Login anbieten wollen, haben es in der Tat etwas einfacher, da sie sich auf die „Minimalanforderungen“ konzentrieren können. Seiten die einen OpenID Connect Provider stellen wollen haben aber folgendes Problem:

    Authorization Requests can follow one of two paths; the Implicit Flow or the Authorization Code Flow. […]
    The OpenID Connect Basic Client profile only documents Clients using the Implicit Flow. OpenID Providers MUST support both flows. […]

    Damit begeht die OpenID Foundation wieder den gleichen Fehler wie bei OpenID 2.0. Am Schluss gibt es so viele unterschiedliche und halbfertige Implemenrierungen, dass man wieder auf SaaS-Dienste wie Janrain oder Gigaya zurückgreifen muss. Wozu braucht es dann noch einen „Standard“?

    Warum denn immer 1000 Alternativen anbieten? Bei Facebook klappts ja auch ohne…

    3 Kommentare zu OpenID Connect Complex
  • BrowserID

    Ich schreibe gerade einen Artikel für das t3n Magazin über aktuelle Sign-In-Mechanismen und hab mir in dem Zuge BrowserID mal etwas genauer angeschaut. Ich bin wirklich extrem überrascht mit wie wenig Arbeit es sich in z.B. WordPress einbauen lässt.

    BrowserID besteht eigentlich nur aus einem JS-File,ein paar Zeilen JS-Code:

    <script src="https://browserid.org/include.js" type="text/javascript"></script>
    <script type="text/javascript">
    navigator.id.get(function(assertion) {
        if (assertion) {
            // This code will be invoked once the user has successfully
            // selected an email address they control to sign in with.
        } else {
            // something went wrong!  the user isn't logged in.
        }
    });
    </script>Code-Sprache: HTML, XML (xml)

    und dem anschließenden Verifizieren der assertion:

    $ curl -d "assertion=&audience=https://mysite.com" "https://browserid.org/verify"
    {
        "status": "okay",
        "email": "lloyd@example.com",
        "audience": "https://mysite.com",
        "expires": 1308859352261,
        "issuer": "browserid.org"
    }Code-Sprache: JavaScript (javascript)

    Den ausführlichen Ablauf der Authentifizierung findet ihr auf Github.

    Um BrowserID in WordPress zu integrieren lädt man also zuerst den JS-Code in den Login Header:

    // add the BrowserID javascript-code to the header
    add_action('login_head', 'bi_add_js_header');
    function bi_add_js_header() {
      echo '<script src="https://browserid.org/include.js" type="text/javascript"></script>';
      echo '<script type="text/javascript">'."\n";
      echo 'function browser_id_login() {
        navigator.id.get(function(assertion) {
          if (assertion) {
            window.location="' . get_site_url(null, '/') .'?browser_id_assertion=" + assertion;
          } else {
            // do nothing!
          }
        })
      };'."\n";
      echo '</script>';
    }Code-Sprache: PHP (php)

    und platziert den BrowserID-Button auf der Login-Seite:

    // add the login button
    add_action('login_form', 'bi_add_button');
    function bi_add_button() {
      echo '<p><a href="#" onclick="return browser_id_login();"><img src="https://browserid.org/i/sign_in_blue.png" style="border: 0;" /></a></p>';
    }Code-Sprache: HTML, XML (xml)

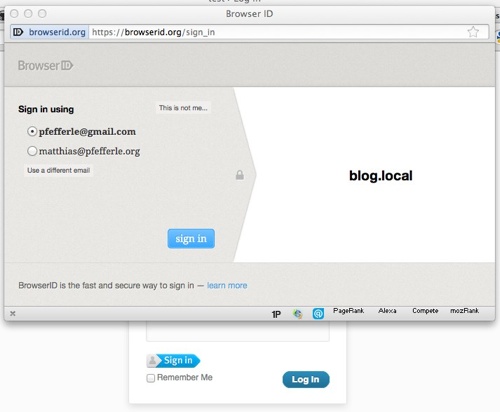
    Nach dem klick auf den Button öffnet sich das Autorisierungs-Fenster von BrowserID und nach dem erfolgreichen Sign-In wird die gerade implementierte Methode navigator.id.get(function(assertion) {} aufgerufen.

    BrowserID login window

    Im nächsten Schritt muß man die erhaltene assertion über BrowserID.org verifizieren. Da ich den notwendigen POST nicht über JavaScript absetzen will, leite ich einfach auf eine Seite weiter und übergebe die erhaltene assertion als GET-Paramater.

    if (assertion) {
      window.location="' . get_site_url(null, '/') .'?browser_id_assertion=" + assertion;
    }Code-Sprache: JavaScript (javascript)

    Jetzt kann der POST bequem über WordPress abgesetzt werden.

    // the verification code
    add_action('parse_request', 'bi_verify_id');
    function bi_verify_id() {
      global $wp_query, $wp, $user;
    
      if( array_key_exists('browser_id_assertion', $wp->query_vars) ) {
        // some settings for the post request
        $args = array(
          'method' => 'POST',
          'timeout' => 30,
          'redirection' => 0,
          'httpversion' => '1.0',
          'blocking' => true,
          'headers' => array(),
          'body' => array(
            'assertion' => $wp->query_vars['browser_id_assertion'], // the assertion number we get from the js
            'audience' => "http://".$_SERVER['HTTP_HOST'] // the server host
          ),
          'cookies' => array(),
          'sslverify' => 0
        );
    
        // check the response
        $response = wp_remote_post("https://browserid.org/verify", $args);
    
        if (!is_wp_error($response)) {
          $bi_response = json_decode($response['body'], true);
    
          // if everything is ok, check if there is a user with this email address
          if ($bi_response['status'] == 'okay') {
            $userdata = get_user_by('email', $bi_response['email']);
            if ($userdata) {
              $user = new WP_User($userdata->ID);
              wp_set_current_user($userdata->ID, $userdata->user_login);
              wp_set_auth_cookie($userdata->ID, $rememberme);
              do_action('wp_login', $userdata->user_login);
    
              wp_redirect(home_url());
              exit;
            } else {
              // show error when there is no matching user
              echo "no user with email address '" . $bi_response['email'] . "'"; 
              exit;
            }
          }
        }
        
        // show error if something didn't work well
        echo "error logging in"; 
        exit;
      }
    }Code-Sprache: PHP (php)

    Gibt es einen User mit der entsprechenden E-Mail – Adresse wird er eingeloggt, falls nicht, wird ein Fehler ausgegeben.

    Bei der Demo hab ich mir aus Zeitgründen ein wenig Code bei Marcel Bokhorst geliehen, dessen BrowserID-Plugin wesentlich ausgereifter und vollständiger ist als der kleine Demo-Code den ich hier zusammengestückelt habe.

    Wenn euch das zu schnell ging und ich auf einige Details nicht genügend eingegangen bin, könnt ihr gerne fragen 🙂

    Ich habe den kompletten Code übrigens auch auf Github hochgeladen… das ist einfacher als sich alles zusammen zu kopieren.

    6 Kommentare zu BrowserID – as easy as copy & paste