Schlagwort: FediBlog

  • Neben all den negativen Meldungen endlich mal wieder ein Highlight für OpenID: Seit dieser Woche ist PayPal offizieller OpenID-Provider mit allen Schikanen (OpenID 2.0, OpenID Simple Registration, OpenID attribute exchange, OpenID user interface, PAPE specification).

    Die Meldung ist nicht nur erfreulich, sondern vielleicht auch die Rettung des etwas angeschlagenen offenen Standards. Trotz des eher hinkenden Vergleichs, wurde OpenID immer mit dem Erfolg von Facebook Connect gemessen. Die OIDF hat es durchweg versäumt den Standard als reines „Werkzeug“ sehen und die Produkte basierend auf OpenID zu promoten. Wie ich schon im Webstandards-Magazin (Ausgabe 9: Pfefferles OpenWeb) schrieb:

    Facebook Connect ist nicht wegen seinem proprietären System so erfolgreich und der Misserfolg von MySpaceID hat nichts mit den benutzten offenen Standards zu tun. Promote the utility not the technologie. To reach the majority of users who aren’t familiar with OpenID as a technology, promote the ability to log in using an existing account, not „OpenID“ itself. Ich würde sagen das Problem liegt nicht am Protokoll sondern an den fehlenden sinnvollen Anwendungsfällen. OpenID funktioniert überall da, wo der User einen Nutzen hat ohne zu wissen was unter der Oberfläche passiert, beispielsweise „Sign in with Google“ oder „Sign in with Yahoo!“. Wo bleiben also die Killerapplikationen wie z.B. Paypals angekündigtes Express Checkout auf Basis von OpenID?

    Reines Single-Sign-On ist ein Geek-Thema und scheint wohl kein generelles Bedürfnis zu befriedigen. Ein „Mit einem Klick-Bezahlen“ ist dagegen eine enorme Chance für Einkäufer und kleine Verkäufer. Wo man bisher, oft durch die langwierige Anmeldung und das hinterlegen der Kontodaten, trotz günstigerer Angebote doch wieder bei Amazon bestellt hat, bietet PayPal in Zukunft vielleicht die Lösung: Schnelles, unkompliziertes und sicheres Einkaufen mit einem „Klick“.

    Hoch lebe OpenID 🙂

    3 Kommentare zu PayPal: Die letzte Chance für OpenID?
  • Google, Yahoo! und Bing haben heute angekündigt, dass sie beim Thema Websemantics zukünftig zusammen arbeiten werden und sich auf einen gemeinsamen Standard einigen wollen (wie vorher auch bei den Sitemaps, robots.txt, um.).

    Auf schema.org findet man eine Übersicht alle Schemas die die Suchgiganten in Zukunft unterstützen werden:

    This site provides a collection of schemas, i.e., html tags, that webmasters can use to markup their pages in ways recognized by major search providers. Search engines including Bing, Google and Yahoo! rely on this markup to improve the display of search results, making it easier for people to find the right web pages.

    Was mich besonders freut: Die Schemas basieren alle auf Microdata und wer meinen Blog regelmäßig verfolgt wird wissen, dass ich das Format sehr schätze! Hier ein Beispiel wie eine Person mit dem neuen Schema aussieht:

    <div itemscope itemtype="http://schema.org/Person">
      <span itemprop="name">Jane Doe</span>
      <img src="janedoe.jpg" itemprop="image" />
    </div>Code-Sprache: HTML, XML (xml)

    Soweit so gut, aber… es werden WIEDER einmal weder bestehende Microformats, noch RDFa Schemas auf Microdata portiert, was dazu führt dass mir spontan 5 unterschiedliche Formate einfallen um Personen zu beschreiben: hCard (Microformats), Data-Vocabulary (RDFa- und Microdata-Beschreibung genutzt von den rich-snippets), FoaF (RDFa), vCard (RDFa), schema.org (Microdata).

    Die Microformats-Community hat von Anfang an eines richtig gemacht: Es gibt nur eine Stelle an der Microformats definiert werden und man muss einen relativ langwierigen Prozess befolgen um ein neues Format zu definieren. Das führt zwar dazu dass es bisher nur eine handvoll Schemas veröffentlicht wurden, diese aber wohl definiert sind und in der Regel auf bisherigen Formaten aufbauen. Die hCard ist beispielsweise ein 1:1 Abbild der vCard.

    Schema.org ist zwar eine ganz nette Idee aber man hat leider versäumt sich mit der Microformats-, RDFa-, RDF- Community zusammenzusetzen und einen gemeinsamen Konsens zu finden!

    Wäre folgendes Beispiel so viel komplizierter?

    <div itemscope itemtype="http://microformats.org/profile/hcard">
      <span itemprop="fn">Jane Doe</span>
      <img src="janedoe.jpg" itemprop="photo" />
    </div>Code-Sprache: HTML, XML (xml)

    …oder das?

    <div itemscope itemtype="http://www.w3.org/2006/vcard/ns">
      <span itemprop="fn">Jane Doe</span>
      <img src="janedoe.jpg" itemprop="photo" />
    </div>Code-Sprache: HTML, XML (xml)

    Das Format ist letztendlich Geschmackssache… der eine mag lieber die einfachen Microformats, der andere steht mehr auf RDFa und ich bevorzuge Microdata, man sollte sich aber endlich auf ein einheitliches Schema einigen!

    Yahoo! zählt knapp zwei Milliarden hCards in ihrem Index und trotzdem diktiert man Webseitenbetreibern etwas komplett anderes auf…

    12 Kommentare zu Websemantics: Google, Yahoo! und Bing einigen sich auf einen „Standard“
  • OpenWeb-Kolumne (wsm)

    Damit das ganze Zeug über das ich so einmal im Quartal im Webstandards-Magazin schreibe nicht pure Science Fiction bleibt, hab ich mich die letzten Wochen mal daran gemacht, ein bisschen Federated Social Web für WordPress zu basteln!

    Vor einigen Monaten kam Pepijn de Vos auf mich zu, ob ich ihm nicht bei einem „OStatus for WordPress“ (noch nicht runterladen! funktioniert noch nicht!) helfen wolle. Das damals größte Problem: Wie können wir so viele besehenden Plugins (pubsubhubbub, webfinger, …) wiederverwenden, ohne die Installation zu kompliziert zu gestalten. Da dieses Problem mittlerweile behoben ist und auch das Salmon-Plugin einigermaßen funktioniert, ist es Zeit für einen Test!

    Ich würde mich freuen, wenn ihr zwei, drei oder vier Leser da draußen mal diesen Blog bei Status.net oder Identi.ca (oder bei jedem anderen StatusNet-Klon) abonnieren und wie wild auf diesen Artikel antworten könntet. Dazu müsst ihr einfach pfefferle at notizblog dot org folgen:

    …und auf diesen Post antworten:

    Was bisher funktioniert:

    • Artikel landen in Echtzeit bei StatusNet/Identi.ca (pubsubhubbub)
    • Antworten auf diese Artikel landen als Kommentare bei WordPress (salmon)

    Zukünftige Features:

    • Kommentare auf WordPress-Seite sollen auch nach StatusNet/Identi.ca geschrieben werden
    • Bessere Integration in BuddyPress
    • …alles was euch noch so einfällt!?!

    Ich würde mich sehr über Feedback, Fragen, Anregungen, Kritik, … freuen. Viel Spaß beim testen!

    …sollte alles gut funktionieren, werde ich die Plugins dann nächste Woche veröffentlichen, also TESTEN!

    14 Kommentare zu FederatedPress
  • …darum geht es in der OpenWeb Kolumne des aktuellen Webstandards-Magazins (seit gestern (18.12.2010) im Fachhandel). Hier ein kleiner Auszug:

    DataPortability war das Thema in 2008, 2009 wurde der Begriff OpenWeb geprägt und nun dreht sich alles um das Federated Social Web.

    Chris Messina nennt es Distributed Social Network (kurz DiSo), bei Khris Loux heißt es SynapticWeb, Chris Saad bevorzugt das Interoperable Web und Evan Prodromou führt jetzt noch einen weiteren Begriff ein: „Federated Social Web“. Aber wo liegen die Unterschiede?

    Würde mich sehr über euer Feedback freuen!

    …man kann sich übrigens gerade alle alten Ausgaben des Magazins für lau runterladen… es kosten nur einen Tweet!

    4 Kommentare zu The Federated Social Web
  • Erst filtern, dann abonnieren!

    Die Informationsflut im Internet nimmt immer mehr zu und FeedReader bieten bisher keine wirkliche Möglichkeit diese Informationen sinnvoll zu filtern und da man nicht wirklich (zeitnah) Einfluss auf die Weiterentwicklung von NetNewsWire, Google Reader & Co. hat, bleibt nur noch eins: Erst filtern, dann abonnieren!

    NoisePress erlaubt Seitenbesucher, einen RSS/ATOM-Feed mit Hilfe von APML vorzufiltern.

    (Zum ausprobieren braucht man ein APML-Profil. Wer keines hat, sollte sich entweder das WordPress Plugin installieren oder heimlich Carstens Profil benutzen 😉 )

    Warum mit APML filtern?

    Man könnte natürlich auch mit WordPress-Bordmitteln eine Menge Rauschen ausfiltern, und wirklich nur das abonnieren was gerade wichtig ist:

    Das Problem: Ändert sich dieses Interesse, müssen alle Feeds mühsam aussortiert (und neue gesammelt) werden. Außerdem besteht die Gefahr, dass einige spannende Themen, die nicht genau die abonnierte Kategorie/den abonnierten Tag besitzen, durch das Raster fallen können.

    Das Prinzip von NoisePress: APML ist eine Art semantische Tag-Clound die das Interesse einer Person widerspiegelt. Das Interessens-Profil wird in der Regel automatisch generiert und sollte sich somit auch den diversen Interessensveränderungen anpassen.

    Am Beispiel WordPress Plugin: Das Plugin erstellt ein APML-File anhand der Häufigkeit der verwendeten Tags und Kategorien. Schreibt jemand viel über OpenID, kann man davon ausgehen, dass er das Thema für wichtig hält. Ändert sich der Fokus des Blogs, wird OpenID auch im APML-Feed immer irrelevanter.

    Hört sich nach Geek-Zeugs an?

    Richtig! 🙂 …aber NoisePress ist auch erst einmal nur ein Test ob meine Idee überhaupt funktioniert! Im besten Fall soll der User von all der Technik gar nichts mitbekommen. Ich hoffe dass sich Firefox‘ Account Manager oder XAuth schnell weiter entwickeln und ich eine dieser Techniken für NoisePress missbrauchen könnte.

    Ich würde mich übrigens sehr über ein bisschen Feedback freuen!

    2 Kommentare zu NoisePress: Nie wieder irrelevante Inhalte
  • Eran Hammer-Lahav hat einen sehr schönen Artikel über das „verschwendete“ Potential der Facebook-Entwickler veröffentlicht:

    […] In fact, the problem is just how unbelievable the Facebook team is (in a good way). The sheer strength of their talent is almost unmatched in our industry, past and present. The problem is, all that talent is building something I just don’t care about, and no one is left for anything else.
    […] There are many reasons why engineers want to work for Facebook, from the potential windfall to learning just how they are able to ship so much technology so fast. It is an engineering dreamland. But there is one great reason why they shouldn’t: because Facebook will be great without them, but the web might not.

    Irgendwie spricht er mir damit aus der Seele! Technologisch gesehen ist Facebook ein Traum (Open Graph Protocol, OAuth 2, Microformats, OpenID (schon bald auch OpenID Connect), uvm.), mit dem Social Network kann ich aber leider nur wenig anfangen…

    2 Kommentare zu Perlen vor die Säue
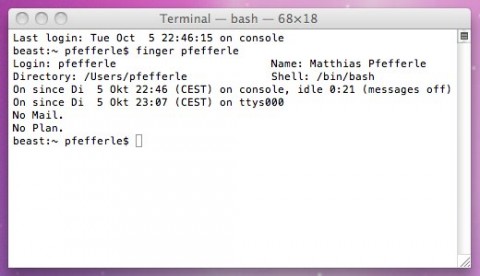
  • Webfinger ist ein relativ neues Web-Protokoll um Informationen über einen User anhand seiner E-Mail – Adresse zu erfragen (um z.B. auch Mail-Adressen zu einer OpenID zu machen). Der Name und die Idee stammt von einem „alten“ Linux-Protokoll namens finger:

    Finger zeigt Informationen über einen bestimmten Benutzer auf einem lokalen System oder auf einem fernen Computer an oder dient zur Feststellung der Verfügbarkeit eines bestimmten Hosts in IP-Netzwerken.

    Quelle: Wikipedia

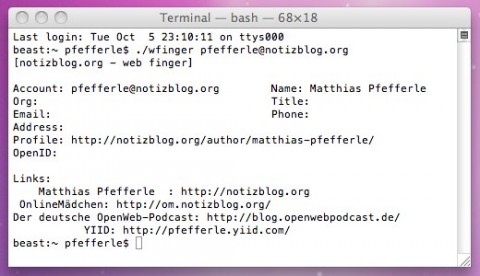
    Damit diese beiden Protokolle nicht nur den Namen teilen, hat Chuck Houpt ein kleines Script geschrieben, mit dem sich Webfinger-Informationen auch über die Konsole abfragen lassen.

    Braucht wahrscheinlich kein Mensch und ist trotzdem (oder vielleicht gerade deshalb) fantastisch!

    1 Kommentar zu wfinger – webfinger für die konsole
  • Durch einen Artikel auf ReadWriteWeb (5 Great YQL One-Liners) bin ich nach langer Zeit mal wieder auf Yahoos YQL-Plattform gelandet und habe nicht schlecht gestaunt, was die Yahoo Query Language mittlerweile alles leistet (mehr über YQL hier). Ich hatte z.B. keine Ahnung, dass man auch eigene table definition schreiben kann und dass es auch schon eine ziemlich fleißige Community um diese Definitionen gibt.

    Meine Favoriten sind:

    Microformats

    select * from microformats where url='http://wait-till-i.com'Code-Sprache: JavaScript (javascript)

    …findet diverse Microformats. » Direct Link

    Mehr dazu hier: SELECT * FROM microformats

    OpenID

    select * from openid.discover where normalizedId="http://www.yahoo.com/"Code-Sprache: JavaScript (javascript)

    …klassische OpenID-Discovery. » Direct Link

    select * from openid.yadis where uri="http://www.yahoo.com/"Code-Sprache: JavaScript (javascript)

    …YADIS-Discovery. » Direct Link

    …und es gibt noch ’ne Reihe anderer OpenID Queries… es sollte sogar möglich sein einen kompletten OpenID-Client mit YQL zu bauen.

    OAuth

    select * from oauth where uri='http://example.com' and consumerKey='asd123' and consumerSecret='zxc456' and callbackUri='http://example.com';Code-Sprache: JavaScript (javascript)

    …sendet einen OAuth-Request. » Direct Link

    pubsubhubbub

    insert into pubsubhubbub.publisher (hub_url, topic_url) values ('http://pubsubhubbub.appspot.com/publish', 'http://developer.yahoo.com')Code-Sprache: JavaScript (javascript)

    …sendet ein Update an das angegebene Hub. » Direct Link

    Webfinger

    select * from webfinger where account='pfefferle@gmail.com'Code-Sprache: JavaScript (javascript)

    …Webfinger-Discovery. » Direct Link

    OpenSocial

    select * from opensocial.peopleCode-Sprache: JavaScript (javascript)

    …sendet eine OpenSocial People-Anfrage. » Direct Link

    Social Graph API

    select * from socialgraph.lookup where q = "notiz.blog" AND edo = "1"Code-Sprache: JavaScript (javascript)

    …ermöglicht Zugriff auf Googles Social Graph API. » Direct Link

    Atom

    select * from atom where url='https://notiz.blog/feed/atom'Code-Sprache: JavaScript (javascript)

    …interpretiert Atom-Feeds mit allen möglichen Erweiterungen, beispielsweise der ActivityStreams-Extension. » Direct Link

    Vielleicht bekomm‘ ich die Tage ja auch mal eine Query zusammen 🙂

    3 Kommentare zu Accessing the OpenWeb with YQL
  • …darum geht es in der neusten Webstandards Kolumne der nächsten Ausgabe des Webstandards-Magazins (kommt am Freitag (24.09.2010) in den Fachhandel). Hier ein kleiner Auszug:

    Die OpenID Foundation hat bisher großartige Arbeit geleistet: OpenID hat die Single Sign On-Idee massentauglich gemacht, die DataPortability-Bewegung maßgeblich geprägt und Facebook und Twitter in ihren Connect-Systemen inspiriert. Aber langsam kommt der Standard in die Jahre. User wollen sich nicht mehr einfach nur einloggen, sie wollen Freunde finden, Aktivitäten teilen und Vorschläge für interessante Inhalte erhalten.

    Würde mich sehr über euer Feedback freuen!

    …man kann sich übrigens gerade alle alten Ausgaben des Magazins für lau runterladen… kosten nur einen Tweet!

    2 Kommentare zu OpenID ist tot, lang lebe OpenID!
  • Der Artikel "Single-Sign-On mit Facebook, Twitter und dem Open Stack", den ich für Ausgabe 19 des t3n Magazins geschrieben habe, ist jetzt kostenlos im Heftarchiv verfügbar.

    Immer mehr Webdienste erleichtern ihren Nutzern die Anmeldung, indem Sie statt einer langwierigen Registrierung auf den einfachen Login mit „Facebook Connect“ oder „Sign in with Twitter“ setzen. Wir zeigen, wie das funktioniert, welche Vorteile und Risiken sich daraus ergeben und warum es am Ende auf einen „Universal Login“ mit offenen Standards wie OpenID hinauslaufen könnte.

    Link: Single-Sign-On mit Facebook, Twitter und dem Open Stack

    Viel Spaß beim lesen…

    Keine Kommentare zu t3n: Login leicht gemacht